
AI ra quyết định: TypeSafe giới thiệu System One và Jev
TypeSafe đặt Jev vào lớp System One để trả quyết định có cấu trúc cho phần mềm. Bài viết giải thích API, benchmark và giới hạn trước khi dùng thực tế.

Trong bài này
TypeSafe gọi System One là một lớp model mới dành cho AI ra quyết định trong phần mềm: nhận state dạng văn bản hoặc dữ liệu có cấu trúc rồi trả về câu trả lời đã định kiểu cùng xác suất. Jev là model đầu tiên của lớp này, được mở early access trong thông báo ngày 15/9/2026. TypeSafe cho biết tên Jev lấy cảm hứng từ nhà kinh tế học William Stanley Jevons. Hãng muốn chuyển một phần công việc AI từ “viết câu trả lời rồi để phần mềm đoán ý” sang “trả về quyết định có cấu trúc để code xử lý trực tiếp”.
Đó là lời hứa của nhà cung cấp, chưa phải kết luận độc lập rằng Jev luôn nhanh hơn, rẻ hơn hoặc chính xác hơn mọi LLM. Bài công bố có các kết quả workflow do TypeSafe xây dựng, đồng thời tự nêu những giới hạn về bộ đánh giá, nhãn tham chiếu, lựa chọn model so sánh và độ phức tạp của ví dụ. Đọc kỹ những phần này quan trọng không kém headline “nhanh hơn gần hai bậc độ lớn”.
Ảnh bìa: tác phẩm sắp đặt nghệ thuật tạo sinh “Machine Hallucinations NYC” (2019) của Refik Anadol tại Artechouse NYC. Ảnh: Refik Anadol, Wikimedia Commons, CC BY-SA 4.0; ảnh được chuyển sang WebP khi tải lên.

Ảnh: tác giả chưa rõ, từ Jevons Family Papers, University of Manchester Libraries; Public Domain Mark 1.0.

AI ra quyết định có cấu trúc khác gì chatbot dùng LLM?
Các LLM quen thuộc được thiết kế để tạo chuỗi văn bản. Khi ứng dụng cần phân loại một ticket, chấm mức độ ưu tiên, chọn tuyến xử lý hoặc ước tính một xác suất, đội kỹ thuật thường yêu cầu model trả lời theo JSON hoặc một schema. Sau đó ứng dụng vẫn phải phân tích và xác thực đầu ra, xử lý trường hợp model viết thêm lời giải thích, trả sai định dạng hoặc chọn một giá trị ngoài danh sách mong muốn. Structured output và JSON mode giúp thu hẹp vấn đề, nhưng chúng không biến bài toán nội dung thành bài toán quyết định theo kiến trúc.
TypeSafe chọn một giao diện hẹp hơn. Ứng dụng gửi một state và một hay nhiều câu hỏi được định nghĩa trước. Mỗi câu hỏi cho biết loại câu trả lời cần nhận, hướng dẫn model cần xét, và đôi khi là tập tiêu chí hữu hạn. Model trả về giá trị theo đúng loại đó cùng xác suất; chương trình dùng các trường trả về để rẽ nhánh, xếp hạng hoặc chuyển sang bước khác.
Tài liệu hiện hành mô tả System One là model nhận biết ngôn ngữ tự nhiên nhưng tối ưu cho phán đoán nhanh, có phạm vi rõ. Nó không viết câu trả lời cho khách, không tạo code, và không tạo lời giải thích chuỗi suy luận. Jev hiện nhận văn bản, JSON hoặc mảng giá trị văn bản; tài liệu ghi rõ chưa hỗ trợ đầu vào ảnh, âm thanh hay video. Vì vậy “model ra quyết định” không đồng nghĩa “model làm được mọi việc của một agent”.
| Câu hỏi ứng dụng | Dạng trả lời | Việc code xử lý |
|---|---|---|
| Ticket thuộc nhóm nào? | Chọn một mục trong Choice | Gán ticket cho nhóm hỗ trợ |
| Mức độ bức xúc ở mức nào? | Điểm trên thang Score | Ưu tiên xem xét các trường hợp điểm cao |
| Tin nhắn có yêu cầu hoàn tiền không? | Xác suất có/không trong Noul | Chạy quy tắc tiếp theo hoặc chuyển người duyệt |
Điểm khác biệt quan trọng nằm ở nơi đặt sự linh hoạt. Chat model có thể tạo ra nhiều dạng đầu ra, phù hợp khi người dùng cần trao đổi, giải thích hoặc tổng hợp. System One giới hạn dạng câu trả lời để phần mềm dễ tiêu thụ, nhưng đổi lại lập trình viên phải mô tả trước những loại kết quả hợp lệ. Nếu ứng dụng cần một đoạn văn mới, một kế hoạch dài hoặc một lời giải thích cho người dùng, Jev không thay thế được bước sinh ngôn ngữ đó.
Hai kiểu model có thể đứng cạnh nhau trong một hệ thống. LLM có thể đọc và tóm tắt một yêu cầu phức tạp; code có thể dựng state; Jev có thể trả lời các câu hỏi phân loại hẹp; rồi code áp dụng luật nghiệp vụ, kiểm tra giới hạn và quyết định khi nào phải yêu cầu người thật xem. Cách kết hợp này gần với kiến trúc lai hơn là một cuộc thay thế toàn phần giữa “LLM” và “model mới”.
Jev trả về những gì?
Tài liệu TypeSafe định nghĩa ba primitive: Choice, Score và Noul. Choice dành cho tập lựa chọn rời rạc như billing, technical hoặc account. Kết quả gồm lựa chọn được chọn, phân phối xác suất cho các lựa chọn và confidence. Score dùng khi câu trả lời nằm trên thang mức độ do ứng dụng mô tả, chẳng hạn mức độ bức xúc. Noul trả một giá trị từ 0 đến 1 biểu thị xác suất một mệnh đề là đúng; Noul không có trường confidence riêng.
Quick start chính thức minh họa cách gọi Jev qua SDK Python. Phần dưới tóm tắt luồng dữ liệu và tên trường theo tài liệu, không phải kết quả của một lần chạy thử.
Luồng SDK trong quick start gồm các phần sau:
- Khởi tạo client bằng
client = TypeSafeClient(); SDK đọcTYPESAFE_API_KEYtừ môi trường. - Đưa nội dung ticket vào state, chẳng hạn
ticket = "Customer message text". - Khai báo từng phán đoán:
Choice(...)cho nhóm xử lý,Score(...)cho mức độ bức xúc vàNoul(...)cho câu hỏi có/không. - Gọi
client.system_one(state=ticket, questions={...}), rồi đọcresponse.answers["department"].choice,response.answers["frustration"].scorehoặcresponse.answers["refund_requested"].noul.
Response giữ kết quả theo ID câu hỏi. Choice không chỉ trả về nhãn được chọn: phân phối xác suất còn cho thấy mức của các lựa chọn còn lại. Nhờ vậy code có thể nhận ra ticket đang nằm giữa hai nhóm thay vì chỉ nhìn vào lựa chọn đứng đầu.
Đó là thay đổi về hợp đồng giữa model và chương trình. Với văn bản tự do, nhiều trạng thái có thể biểu đạt gần giống nhau nhưng vẫn cần parsing. Với primitive có kiểu, tập phản hồi được ràng buộc trước. Tài liệu TypeSafe nói giá trị đầu ra của Choice nằm trong các lựa chọn đã cung cấp; Score theo các cấp đã khai báo; Noul nằm trong miền xác suất. Điều này loại bỏ một loại lỗi định dạng như model tự nghĩ ra tên phòng ban thứ tư khi ứng dụng chỉ khai báo ba lựa chọn.
Nhưng schema đúng không đồng nghĩa quyết định đúng. Jev vẫn có thể chọn sai nhóm, hiểu nhầm nội dung ticket hoặc phản ánh xác suất không phù hợp với dữ liệu triển khai của một tổ chức. Ràng buộc kiểu kiểm soát hình dạng câu trả lời; nó không chứng minh nội dung câu trả lời đúng. Đó là một ranh giới cần giữ rõ khi đọc tuyên bố “no type errors” và “can’t hallucinate” trong phần giới thiệu sản phẩm.
Xác suất và confidence không phải lời bảo đảm
Điểm bán hàng cốt lõi của TypeSafe là hiệu chỉnh xác suất. Một model có thể đoán đúng trong nhiều trường hợp nhưng vẫn không đáng dùng nếu nó luôn thể hiện độ chắc chắn cao, kể cả khi dữ liệu thiếu hoặc câu hỏi nằm ngoài phạm vi. Với output có phân phối xác suất, code có thêm tín hiệu để định tuyến trường hợp mơ hồ sang người duyệt, thay vì buộc mọi yêu cầu thành một lựa chọn cứng.
Tuy nhiên, chính tài liệu System One của TypeSafe lưu ý calibration được đo trên nhóm dự đoán: xác suất được thiết kế để phản ánh mức độ đúng trên nhiều trường hợp, chứ không bảo đảm từng câu trả lời riêng lẻ đúng ở đúng mức xác suất đó. Nếu một tập dự đoán ghi 0,8 thì điều đó không phải lời hứa rằng một ticket cụ thể chắc chắn đúng với xác suất chính xác 80%. Chất lượng calibration vẫn cần được kiểm tra trên dữ liệu, ngôn ngữ, nhóm khách hàng và mức độ rủi ro của ứng dụng.
confidence cũng cần đọc đúng nghĩa. TypeSafe mô tả nó là một thống kê được tính từ hình dạng của phân phối xác suất cho Choice và Score. Phân phối tập trung vào một lựa chọn thường thể hiện độ tự tin cao hơn; phân phối dàn trải cho thấy kết quả không rõ ràng. Với Noul, ứng dụng đọc trực tiếp xác suất có/không thay vì dựa vào một trường confidence khác.
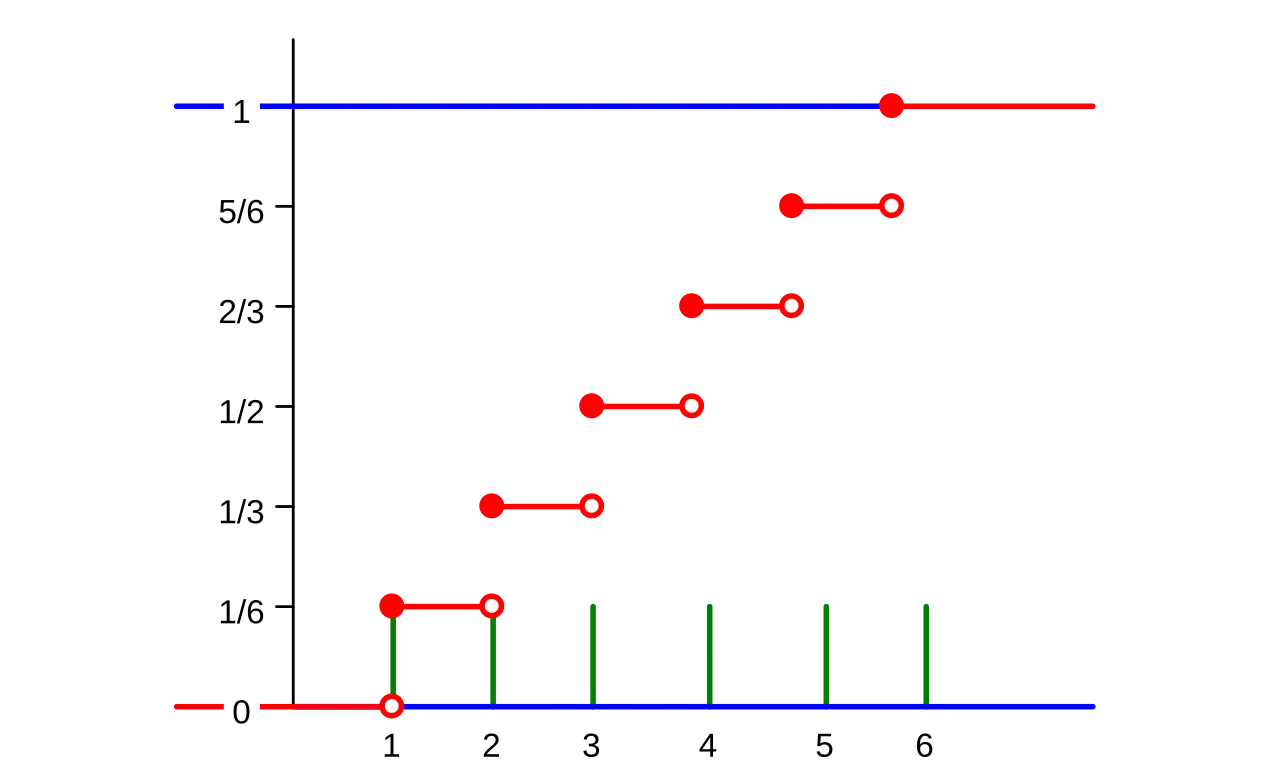
Hình minh họa khái niệm phân phối xác suất, không phải output của Jev. Tác giả Lefschetz, Wikimedia Commons, CC BY-SA 3.0.

Một phân phối sắc nhọn vẫn có thể sai. Nếu tiêu chí thiếu, state bỏ mất thông tin hoặc dữ liệu thực tế khác tập kiểm thử, model vẫn có thể tự tin vào kết luận sai. Ứng dụng nên đặt ngưỡng theo hậu quả của hành động: chọn category để mở màn hình có thể chấp nhận ngưỡng thấp hơn tự động từ chối hoàn tiền, khóa tài khoản hay phê duyệt giao dịch.
Tài liệu của hãng đề xuất chia hành vi theo mức confidence: mức cao có thể cho phép hành động tự động; mức giữa xử lý thận trọng, hỏi thêm hoặc đưa vào hàng chờ; mức thấp thì không hành động. Đây là một mẫu thiết kế, không phải ngưỡng chung cho mọi hệ thống. Trong ví dụ chính thức, quyết định rủi ro cao như chấp thuận chuyển tiền đòi hỏi ngưỡng cao và vẫn gọi bước xác nhận; còn thao tác ít hệ quả hơn có thể dùng quy tắc khác.
Điều đó cũng giúp sửa cách hiểu “không hallucinate”. Jev bị giới hạn không thể trả một loại enum không tồn tại trong schema Choice, nhưng nó vẫn có thể gán ticket vào một enum sai. Nó không viết ra một đoạn giải thích bịa theo nghĩa thông thường của chat model, nhưng xác suất hoặc phân loại sai vẫn có thể gây lỗi trong phần mềm nếu code tin mọi đầu ra. Type safety giảm lỗi hợp đồng; calibration cung cấp thêm thông tin bất định; cả hai không xóa nhu cầu quan sát, kiểm thử và xử lý ngoại lệ.
RLCD, kiến trúc và sampler: điều đã công bố, điều chưa biết
Thông báo của TypeSafe nói hãng xây dựng một stack tập trung vào automation với kiến trúc model mới, một “parallel sampler” và phương pháp huấn luyện tên Reinforcement Learning for Calibrated Decisions (RLCD). Bài viết đặt RLCD cạnh RLHF và RLVR: một bên tối ưu phán đoán có xác suất được hiệu chỉnh, thay vì ưu tiên câu trả lời mà người chấm thích hoặc đầu ra có thể kiểm chứng bằng một bộ thưởng lập trình sẵn.
Những tên gọi đó định hướng người đọc về thiết kế, nhưng thông báo không cung cấp đầy đủ thông số huấn luyện, chi tiết kiến trúc hay một mô tả đủ để tái tạo hệ thống. Do đó bài này không suy đoán RLCD dùng loss function nào, dữ liệu nào hoặc sampler thực thi ra sao. Có thể nói chắc rằng TypeSafe công bố các thành phần trên và mô tả mục tiêu của chúng; chưa thể từ bài công bố kết luận rằng phương pháp mới luôn vượt các cách huấn luyện hiện hành trên mọi tác vụ.
“Parallel” trong bài mô tả cách tạo các đầu ra có cấu trúc của Jev: model tính các phản hồi câu hỏi theo cách TypeSafe nói là song song, thay vì phát token nối tiếp theo từng token như quá trình sinh văn bản autoregressive. Tài liệu nói các câu hỏi cùng request được đánh giá độc lập trên cùng state. Đó là lý do hãng dự đoán chi phí biên và độ trễ thấp khi thêm nhiều câu hỏi trong một request.
Độc lập ở đây có nghĩa là một câu trả lời không trở thành context ẩn cho câu hỏi tiếp theo trong cùng request. Nếu câu hỏi thứ hai thực sự phụ thuộc vào kết quả câu thứ nhất — ví dụ phải chọn bộ lựa chọn dựa trên kết quả đầu — code cần gọi bước sau sau khi đã đọc đáp án đầu. Nếu không có phụ thuộc dữ liệu như vậy, việc yêu cầu nhiều câu hỏi song song có thể giúp giảm nhiều vòng gọi tuần tự. Đây là lựa chọn kiến trúc, không chỉ là đổi cú pháp API.
Một trường hợp đáng chú ý trong bài là lựa chọn có cardinality lớn. TypeSafe nói Jev hỗ trợ tối đa 255 lựa chọn, nhưng một số lựa chọn cardinality cao cần pipeline hai giai đoạn: chấm điểm độc lập trước rồi thực hiện lựa chọn tường minh. Hãng ghi nhận một số độ trễ tăng ở demo Wikiracing do cách này. Chi tiết này nhắc rằng “parallel” không có nghĩa mọi bài toán đều chỉ có một bước đơn giản hoặc độ trễ giống nhau.
Đọc các con số benchmark mà không biến chúng thành lời hứa phổ quát
Trang chủ TypeSafe hiện nêu “193.6x Faster, 444.6x Cheaper”. Bài công bố nói các tỷ lệ đó lấy từ workflow phù hợp với System One và có thể cao hơn mức cải thiện thông thường. Bài nêu độ trễ khoảng 70–500 ms; trang chủ có ví dụ hiển thị 0,114 giây cho Jev và 8,566 giây cho một LLM. Đây là kết quả do TypeSafe công bố, không phải benchmark độc lập cho mọi request.
Thay vì chỉ đọc con số lớn, nên xem benchmark được dựng ra sao. TypeSafe mô tả một harness workflow: cùng một workflow được dùng cho các model; bài toán được tách thành các phán đoán hẹp rồi code kết hợp kết quả, sau đó đánh giá độ gần với tham chiếu. Hãng so sánh trên bốn workflow ví dụ, gồm xử lý cảnh báo bảo mật, đánh giá agent trace, hóa đơn và chăm sóc khách hàng. Mục tiêu là xem model hoạt động bên trong một đồ thị tính toán có sẵn ra sao, thay vì chỉ so một prompt đơn lẻ.
Trong bài ra mắt, nhãn tham chiếu được tạo bằng trung bình phản hồi của GPT-6 Astra và Claude Fable 5.1 ở mức high thinking. Tác giả nói cách này thiên về các model đó và có thể đánh giá thấp tương quan của Jev. Các LLM được gọi qua wrapper “System One LLM” để ép đầu ra về quyết định có cấu trúc; TypeSafe cho biết cách này thường chính xác hơn nhưng chậm và đắt hơn hỏi model trực tiếp.
Hãng cũng nói nội dung workflow không được cố tình dựng để Jev trông tốt hơn và không nằm trong phân phối huấn luyện của model, nhưng nhóm thiết kế workflow thuộc đội năng lực model của TypeSafe, nên vẫn có khả năng tồn tại thiên lệch thiết kế. Hơn nữa, nhóm nghiên cứu “giả định harness đúng” khi so kết quả với nhãn tham chiếu. Nếu workflow tách sai quyết định, hoặc nhãn của hai model tham chiếu không phù hợp với nghiệp vụ thật, điểm số có thể cao mà vẫn không đo đúng giá trị cho doanh nghiệp.
Trang đánh giá chính thức hiện mô tả mọi model đều chính xác hơn, rẻ hơn và nhanh hơn khi chạy trong workflow so với việc giao cùng chính sách thành một prompt. Đây là luận điểm hợp lý về lợi ích của phân rã bài toán: luật rõ ràng giao cho code, các bước phán đoán giao cho model, và kết quả được kết hợp theo quy trình. Nhưng lợi thế đó không riêng Jev. Một hệ thống dùng LLM khác cũng có thể được hưởng lợi từ workflow; điều cần so sánh là model và kiến trúc trong cùng dữ liệu, cùng chi phí tổng, cùng ngưỡng an toàn.
Benchmark nội bộ nên kiểm tra dữ liệu có giống sản xuất không, nhãn đúng do ai đặt, latency đã tính mạng và retry chưa, và metric có cân nhắc chi phí false positive/false negative không. Đội phát triển cũng nên so chi phí end-to-end: Jev hiện miễn phí output token, nhưng tổng chi phí còn gồm tiền xử lý state, retry, các request tuần tự và model khác dùng để sinh ngôn ngữ hoặc xử lý tình huống ngoài danh sách.
Một request API trông như thế nào?
Tài liệu quick start đưa endpoint POST https://api.typesafe.ai/v1/systemone, xác thực bằng bearer key, và phần thân request có state, model cùng map questions. Tên model mặc định trong các ví dụ là jev-latest. Request bên dưới là trích lược cấu trúc từ ví dụ chính thức, giữ nguyên các tên field để người đọc có thể đối chiếu tài liệu:
Request có ba phần chính:
state: văn bản hoặc dữ liệu cần đánh giá.model: ví dụjev-latest.questions: map các câu hỏi theo ID do ứng dụng chọn. Mỗi câu hỏi cótype,instructionsvà, với Choice,criteria. Ví dụquestions.departmentcó kiểuchoicevới các nhãnbilling,technical,sales;questions.refund_requestedcó kiểunoulđể hỏi tin nhắn có yêu cầu hoàn tiền không.
Ứng dụng có thể gửi một câu hỏi hoặc nhiều câu hỏi cho cùng state. Mỗi ID do phía gọi chọn để tìm câu trả lời tương ứng trong response; tài liệu nói ID không được gửi cho model. instructions chứa nội dung câu hỏi thật, và criteria mô tả các đáp án hoặc mức độ hợp lệ. Điều này khiến việc đặt tên ID thật rõ cho người lập trình chưa đủ: hướng dẫn và tiêu chí vẫn cần giải thích ranh giới giữa các lựa chọn.
Ví dụ “chọn nhóm xử lý ticket” có thể trở nên mơ hồ nếu cùng một tin nhắn nói vừa thanh toán lỗi vừa không nhận được email xác nhận. Nếu danh sách chỉ có billing và technical, model buộc phải chọn một trong hai dù thực tế cần chuyển cả hai nhóm hoặc hỏi thêm. Tài liệu Choice khuyên bổ sung other hoặc none of the above khi tập lựa chọn có thể bỏ sót trường hợp. Thực tế, code còn có thể xét các xác suất phụ để gửi bản sao cho nhóm thứ hai khi xác suất vượt ngưỡng đã định.
Một request với nhiều câu hỏi cũng không tự làm các câu hỏi “thông minh hơn” nhờ nhìn thấy đáp án nhau. Theo tài liệu, từng câu hỏi được đánh giá độc lập trên cùng state. Nếu nghiệp vụ cần “nếu hoàn tiền được yêu cầu thì kiểm tra điều kiện X, còn nếu không thì bỏ qua”, có thể hỏi trước các câu hỏi độc lập rồi để code bỏ qua đáp án không cần, hoặc tách thành request sau nếu thật sự cần kết quả đầu làm input cho câu tiếp theo.
Về tích hợp, tài liệu cung cấp SDK Python, SDK JavaScript và endpoint HTTP. Quick start nói Python SDK yêu cầu Python 3.10 trở lên và có thể đọc TYPESAFE_API_KEY từ biến môi trường. Không nên đặt API key trực tiếp vào mã client gửi trình duyệt hoặc log. Bài này không gọi endpoint, không gửi dữ liệu khách hàng và không kiểm tra latency thực tế; các ví dụ chỉ phản ánh shape mà tài liệu TypeSafe công bố.
Nơi Jev phù hợp — và nơi không nên ép dùng
System One hướng tới bước giữa của một workflow: ứng dụng đã có state, biết trước câu hỏi cần trả lời và muốn dùng kết quả để chọn nhánh code. Ví dụ gồm phân loại yêu cầu, định tuyến ticket, phát hiện tín hiệu trong nội dung và chấm điểm theo rubric. Jev trả về giá trị có kiểu cùng xác suất; code vẫn áp dụng chính sách và thực hiện hành động.
Trong luồng hỗ trợ khách hàng, state có thể gồm hội thoại, thông tin đơn hàng đã xác minh và chính sách liên quan. Jev phân loại yêu cầu hoặc chấm mức khẩn cấp; phần mềm đối chiếu với dữ liệu giao dịch rồi phân tuyến hay yêu cầu người xử lý xem. Jev không phải nguồn xác nhận trạng thái đơn hàng, số dư hay quyền truy cập. Những dữ liệu đó phải đến từ hệ thống có thẩm quyền.
Model này không thay thế tác vụ cần viết câu trả lời dài, tạo nội dung, viết code hoặc xử lý suy luận nhiều bước không thể tách an toàn. Nếu state thiếu dữ kiện, lựa chọn bỏ sót trường hợp hoặc xác suất chưa vượt ngưỡng đã đặt, workflow nên hỏi thêm hay chuyển người. Đối với hành động có hệ quả cao, giữ kiểm tra quyền, hạn mức và bước phê duyệt trong code.
Độ trễ, chi phí và giới hạn kỹ thuật cần kiểm tra
Tại thời điểm kiểm tra ngày 23/9/2026, tài liệu Models liệt kê Jev 1.13 (jev-1.13.0) với giá 0,042 USD cho một triệu input token; output token miễn phí. Ngân sách context 64K tính tổng state và tất cả câu hỏi; giới hạn 32K áp dụng cho state cộng với câu hỏi dài nhất. Đây là thông tin có thể đổi; hãy kiểm tra bảng giá, context và rate limit trước khi triển khai. Tài liệu hiện chỉ rõ alias jev-latest trỏ tới jev-1.13.0; alias có thể đổi theo phiên bản. Nếu đã hiệu chỉnh ngưỡng, hãy ghim version và chủ động đánh giá trước khi nâng cấp.
Jev hiện nhận văn bản, JSON hoặc mảng giá trị văn bản; ảnh, âm thanh và video cần được chuyển đổi ở bước khác trước khi đưa vào state. Tài liệu cũng nêu tiếng Anh là ngôn ngữ chính có chất lượng tốt nhất; ngôn ngữ khác cần được thử trên dữ liệu thật. Với workload tiếng Việt, hãy đưa câu có dấu, câu trộn thuật ngữ, viết tắt và lỗi chính tả vào bộ đánh giá.
TypeSafe hiện không cho fine-tune hay LoRA model riêng theo dữ liệu khách hàng. Ứng dụng điều chỉnh bằng state, instructions, criteria và cách chia câu hỏi. Vì vậy chi phí thực tế gồm cả tiền xử lý, request tuần tự, retry và model bổ sung cần thiết cho phần sinh ngôn ngữ.
Output đúng kiểu chưa đủ để hệ thống đáng tin
Một câu trả lời có thể tuân thủ schema nhưng vẫn phân loại sai, dùng rubric mơ hồ hoặc tự tin khi state thiếu dữ kiện. Nên đánh giá riêng ba lớp: hợp đồng dữ liệu có hợp lệ không; dự đoán có đúng theo nghiệp vụ không; và code có ngăn dự đoán sai gây hậu quả không. Typed output chủ yếu giúp lớp đầu. Xác suất hỗ trợ đánh giá lớp hai; lớp an toàn hành động vẫn do ứng dụng thiết kế.
Bộ đánh giá nên có ví dụ thường gặp, ngoại lệ và ranh giới giữa hai nhãn, được gắn nhãn bởi người hiểu nghiệp vụ. Theo loại câu hỏi, đo confusion matrix, sai số theo mức Score, calibration theo nhóm xác suất, latency toàn luồng, chi phí và tỷ lệ chuyển người. Nếu false positive đắt hơn false negative, accuracy tổng không đủ; cần theo dõi precision/recall hoặc metric có trọng số theo chi phí.
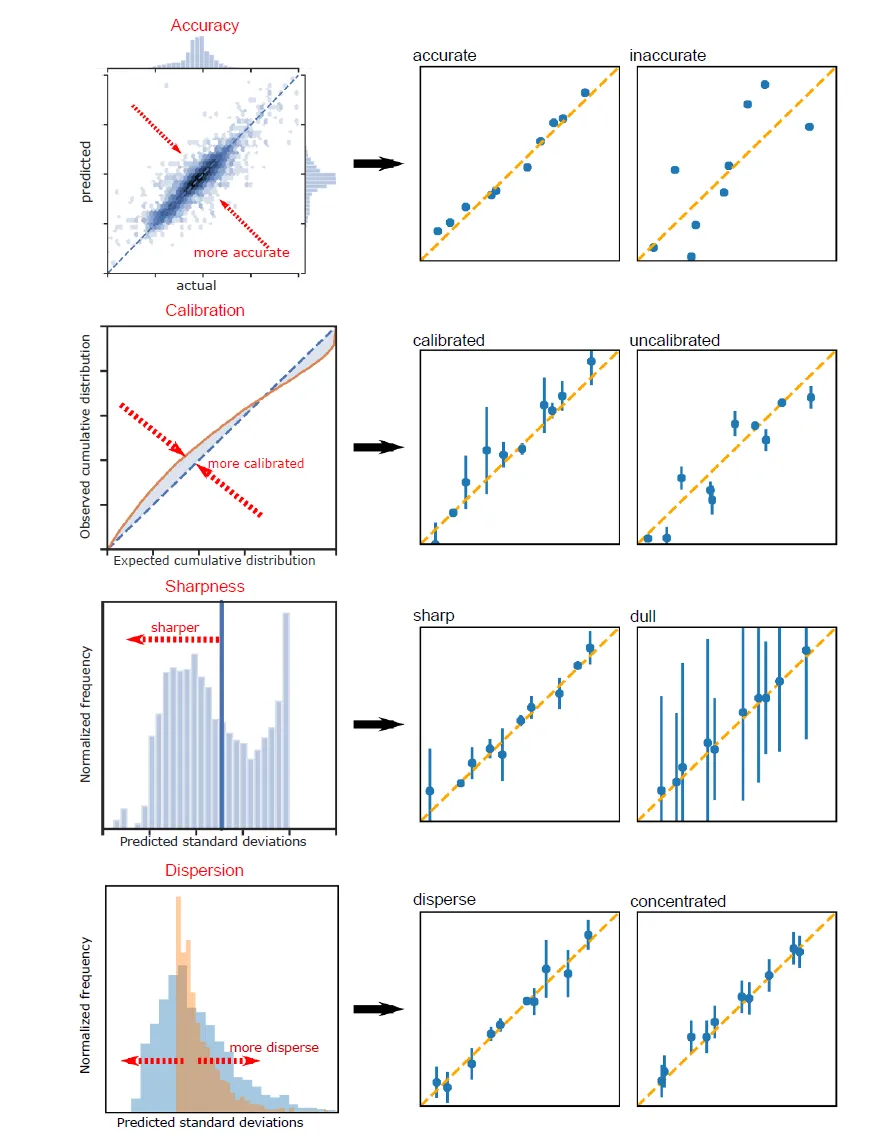
Hình giải thích các chiều đánh giá bất định, không phải kết quả benchmark Jev. Tác giả Kevin Tran, Willie Neiswanger, Junwoong Yoon, Qingyang Zhan, Eric Xing và Zachary W. Ulissi; Wikimedia Commons, CC BY 4.0.

Trước khi cho Jev tạo side effect, chạy shadow mode: ghi nhận dự đoán và so sánh với người xử lý hoặc rule hiện tại. Thử state thiếu hoặc mâu thuẫn, trường hợp ngoài tập lựa chọn và xác suất gần ngưỡng. Log phiên bản model, đặt đường chuyển người và chuẩn bị rollback. Model dự đoán technical không thay thế kiểm tra quyền truy cập, trạng thái bản ghi hay SLA.
Cách đọc lần ra mắt này
Điểm mới TypeSafe đề xuất là một API cho các quyết định hẹp: state, câu hỏi định kiểu, tiêu chí và xác suất để code ghép thành workflow. Điều này đáng thử khi ứng dụng cần một lựa chọn hữu hạn thay vì một đoạn văn mới. Nó không khiến chat model hết vai trò trong giải thích, tổng hợp, sáng tác hay tác vụ nhiều bước.
Các tỷ lệ tốc độ và chi phí lớn trong bài công bố là kết quả TypeSafe tự đo trên bốn workflow. Tham chiếu được tạo từ GPT-6 Astra và Claude Fable 5.1 ở mức high thinking; LLM được gọi qua wrapper ép đầu ra có cấu trúc; đội năng lực model của TypeSafe thiết kế workflow và tác giả nói họ giả định harness đúng. Bài viết cũng cho biết tỷ lệ headline ở phía cao của mức cải thiện. Đây là thông tin hữu ích để hình thành giả thuyết, chưa thay cho phép đo độc lập trên quy trình và dữ liệu của bên triển khai.
Cách kiểm tra phù hợp là chạy cùng dữ liệu qua rule hiện tại, LLM có structured output và Jev; tính cả chất lượng dự đoán, chi phí end-to-end và hậu quả của sai sót. Tách một tập giữ lại trước khi tinh chỉnh criteria, sau đó chạy shadow mode rồi chỉ tự động hóa các trường hợp rủi ro thấp đã đạt ngưỡng. Giá trị của Jev sẽ phụ thuộc vào workload, ngôn ngữ, state, câu hỏi và cách code xử lý trường hợp không chắc.
Nguồn đọc tiếp
- Bài công bố Introducing System One Models & Jev — tuyên bố sản phẩm, benchmark và các giới hạn do TypeSafe nêu.
- System One trong tài liệu TypeSafe — mô tả model, giới hạn đầu vào và vị trí trong workflow.
- Quick start — ví dụ API, response và SDK.
- Primitives: Choice, Score, Noul — kiểu câu hỏi và cấu trúc kết quả.
- Confidence — cách đọc xác suất và dùng ngưỡng theo rủi ro.
- Models — version, giá, context, rate limit và ngôn ngữ.
- Workflow evals — harness và bốn workflow do TypeSafe công bố.
Ghi chú biên tập: số liệu hiệu năng, giá và so sánh trong bài là thông tin TypeSafe công bố hoặc nêu trong tài liệu hiện hành; chưa có replication độc lập được kiểm tra trong bài. Các hình minh họa có nguồn và giấy phép ghi tại chú thích.
Viết và kiểm chứng bởi Nguyễn Hoàng Lộc (Beru), TP. Hồ Chí Minh